
Un chiffre faux ne se signale pas tout seul. Il circule, il passe dans un rapport, il est présenté en réunion, et quelqu'un finit par remarquer que le résultat du mois dernier a changé sans explication. À ce moment, le problème a cessé d'être technique. C'est la confiance dans les chiffres qui est entamée, et elle se regagne beaucoup plus lentement qu'elle ne se perd.
La gestion de la qualité des données consiste à éviter ce scénario de façon organisée, au lieu de corriger les erreurs une par une quand elles remontent. Les sept étapes décrites plus bas s'appliquent à une entreprise de taille moyenne, avec ou sans équipe de données dédiée.
Ce que recouvre la gestion de la qualité des données
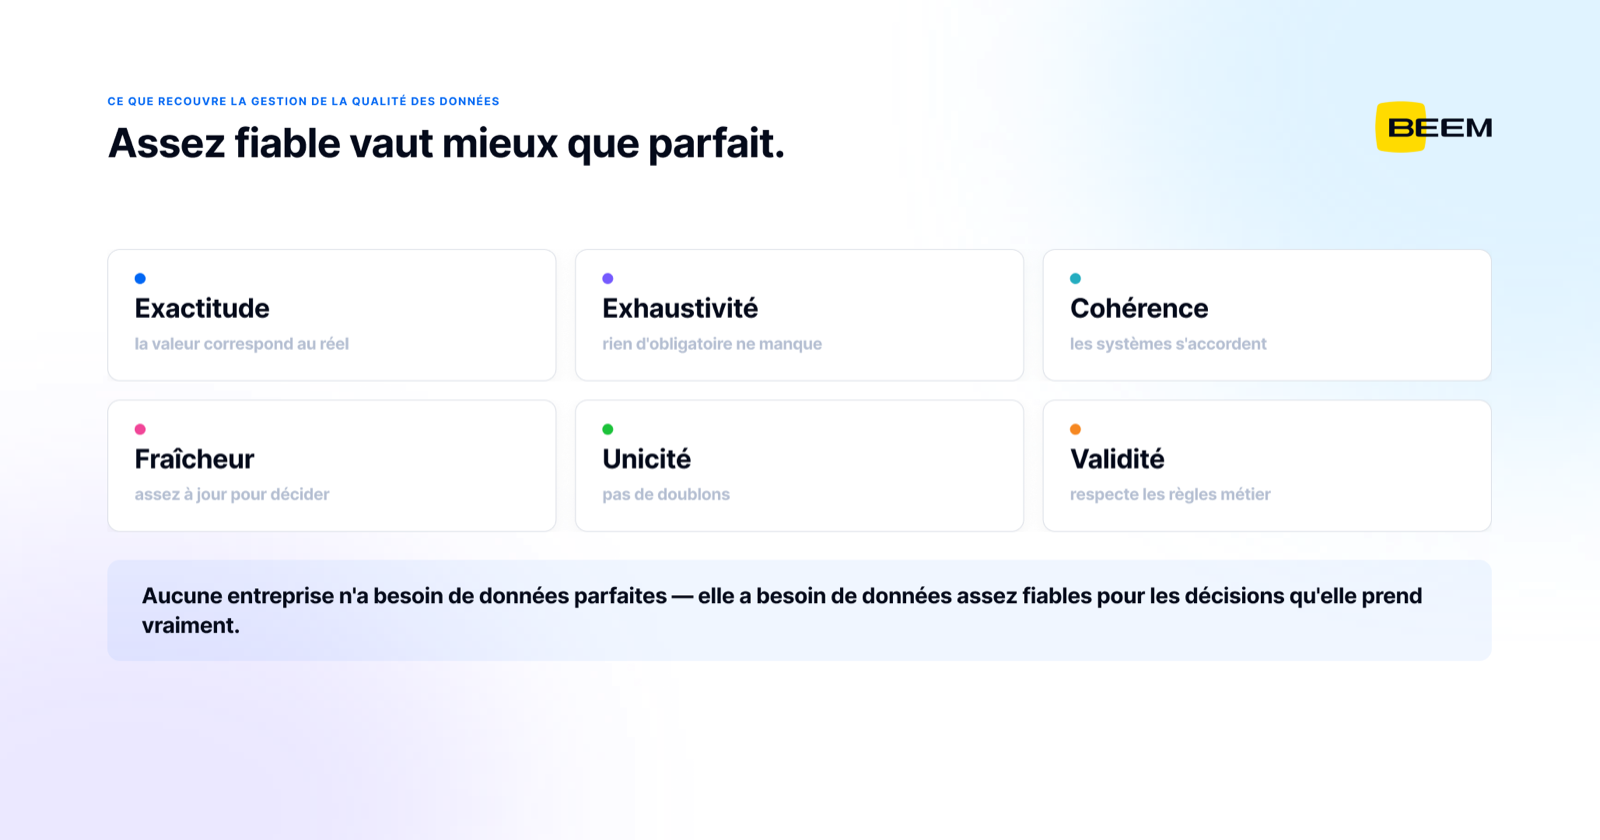
Il s'agit de l'ensemble des règles, des contrôles et des responsabilités qui garantissent que les données utilisées pour décider correspondent à la réalité qu'elles décrivent. Les référentiels du secteur s'accordent sur six dimensions : l'exactitude, la complétude, la cohérence entre les systèmes, la fraîcheur, l'unicité, c'est-à-dire l'absence de doublons, et la validité au regard des règles métier.
Une précision utile avant d'aller plus loin. Il ne s'agit pas d'un projet de nettoyage ponctuel. Une base assainie en janvier redevient approximative en juin si rien n'empêche les erreurs d'entrer. La démarche comporte donc une part technique et une part organisationnelle, et c'est la seconde qu'on néglige le plus souvent.
Dernier point de cadrage : aucune entreprise n'a besoin de données parfaites. Elle a besoin de données assez fiables pour les décisions qu'elle prend réellement. Confondre les deux conduit à des mois de travail sur des champs que personne ne consulte.
Pourquoi la qualité se dégrade même avec de bons outils
Selon Gartner, la mauvaise qualité des données coûte en moyenne 12,9 millions de dollars par année aux organisations, et l'incohérence des données d'une source à l'autre figure en tête des problèmes les plus difficiles à corriger. Le chiffre est une estimation issue de leurs travaux auprès de grandes entreprises, mais l'ordre de grandeur donne une idée de ce qui se joue.
La dégradation vient rarement d'une négligence. Elle vient de la façon dont les outils s'accumulent. Chaque logiciel adopté arrive avec ses propres règles de saisie, ses propres identifiants et sa propre définition de ce qu'est un client actif ou un projet en cours. Personne n'est chargé d'arbitrer entre ces définitions, alors elles coexistent. La saisie manuelle fait le reste, avec les fautes de frappe, les champs laissés vides et les valeurs inventées pour pouvoir enregistrer un formulaire.
Les effets se voient d'abord dans les opérations : ressaisie des mêmes informations dans deux systèmes, rapports qui ne concordent pas d'une direction à l'autre, cycles de clôture allongés par des vérifications manuelles. Ils se voient ensuite dans les décisions, quand une prévision repose sur un historique incomplet sans que personne ne le sache au moment de la présenter.
Un cas client documenté dans la construction montre à quoi ressemble l'accumulation. L'entreprise combinait un ERP sur site, une plateforme infonuagique de gestion de projets, des outils RH et un CRM. Les données arrivaient dupliquées, incohérentes et non normalisées, au point que l'équipe passait des heures à nettoyer des fichiers Excel à la main avant de les transférer dans Power BI. La direction n'avait aucune vue fiable sur les coûts de projet ni sur les marges. Après normalisation et automatisation des flux, les doublons et les incohérences ont été éliminés et le nettoyage manuel a disparu du quotidien des équipes.
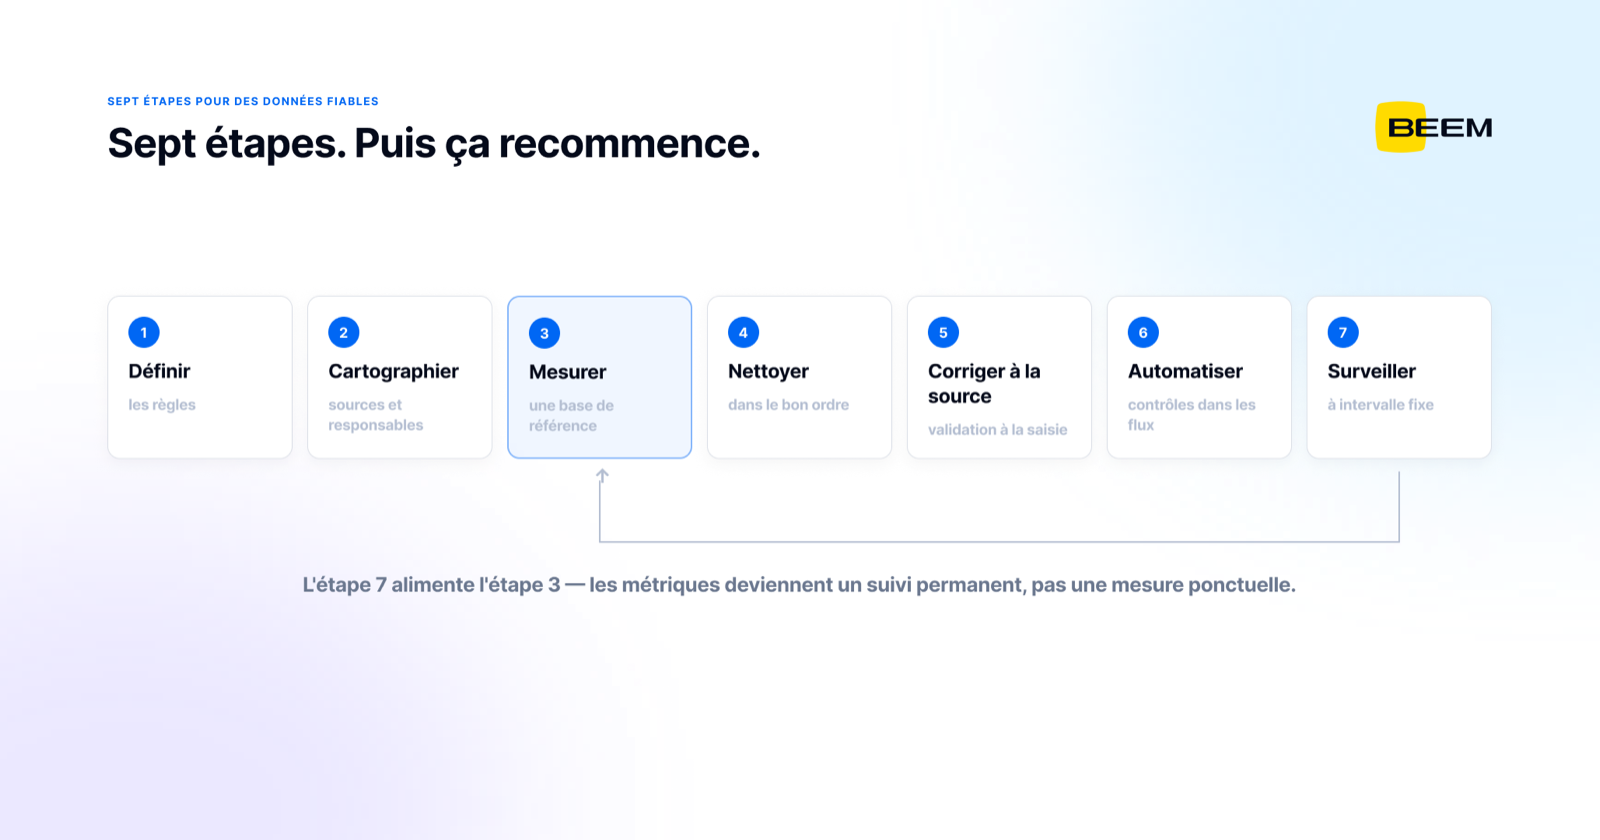
Sept étapes pour obtenir des données fiables
Les meilleures pratiques de qualité des données se ressemblent d'un référentiel à l'autre. Ce qui change, c'est l'ordre dans lequel on les applique, et c'est là que la plupart des démarches se perdent. Elles commencent par choisir un outil de nettoyage alors que rien n'a encore été défini ni mesuré.
1. Définir ce que fiable veut dire, domaine par domaine
Avant tout contrôle, il faut écrire les règles. Un numéro de client respecte tel format. Une facture ne peut pas exister sans date d'échéance. Un nom d'entreprise s'écrit d'une seule manière. Ces règles paraissent évidentes tant qu'elles restent implicites, et cessent de l'être dès qu'on compare ce que trois équipes ont saisi. Le travail avance par domaine, les clients, les produits, les projets, les employés, plutôt que sur toute l'entreprise en même temps, sinon il n'aboutit jamais.
2. Cartographier les sources et nommer un responsable pour chacune
Chaque système qui produit ou modifie une donnée entre dans l'inventaire, avec sa fréquence de mise à jour et son propriétaire métier. Les connexions entre les systèmes font partie de la carte, y compris les exports manuels que personne n'a documentés. Qui tranche quand le CRM et l'ERP affichent deux adresses différentes pour le même client ? Sans un nom en face de chaque source, cette question reste ouverte pendant des mois.
3. Mesurer avant de corriger
Les métriques de qualité des données transforment une impression en constat. Taux de complétude par champ obligatoire, nombre de doublons détectés, écart entre deux systèmes sur un même indicateur, fraîcheur moyenne des enregistrements, part des données qui échouent aux règles écrites à la première étape. Cette mesure initiale sert de point de comparaison, et c'est elle qui permettra plus tard de montrer que la démarche a produit un résultat.
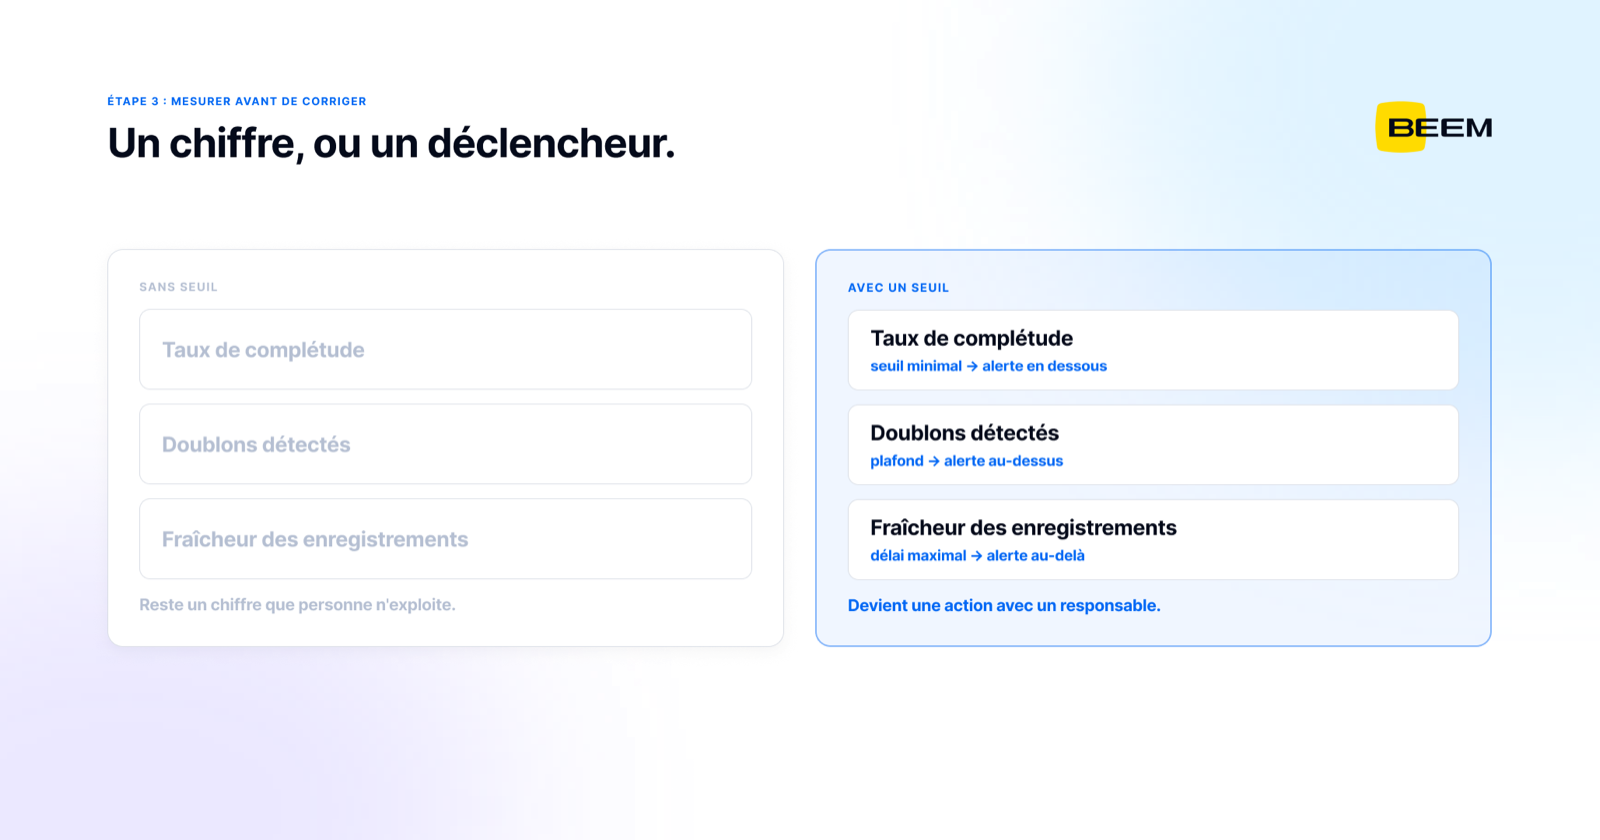
Mieux vaut retenir quatre ou cinq indicateurs suivis sérieusement qu'une batterie de mesures que personne ne regarde. Chacun gagne à recevoir un seuil explicite, par exemple un taux de complétude minimal sur les champs qui alimentent la facturation, ou un délai maximal entre la production d'une donnée et sa disponibilité dans les rapports. Sans seuil, une métrique reste un chiffre : avec un seuil, elle déclenche une action.
4. Nettoyer dans le bon ordre
Le nettoyage des données suit une séquence qui a son importance. Normaliser d'abord les formats, dates, devises, unités, casse des textes. Dédoublonner ensuite. Réconcilier les identités entre les systèmes. Compléter en dernier ce qui manque encore. Dédoublonner avant de normaliser revient à comparer des enregistrements qui ne se ressemblent pas encore, et à laisser passer des doublons pourtant évidents. Ces traitements gagnent à être intégrés aux pipelines de transformation plutôt que refaits à la main à chaque cycle.
La réconciliation des identités mérite une attention particulière, parce que c'est l'étape où les erreurs coûtent le plus cher. Il faut décider sur quoi deux enregistrements sont considérés comme identiques, un numéro de compte, un domaine de courriel, une combinaison de critères, et surtout quel système fait autorité quand les valeurs diffèrent. Une fusion mal réglée détruit de l'information au lieu d'en produire, et cette perte se remarque des mois plus tard.
5. Corriger à la source dès que c'est possible
Un enregistrement corrigé en aval redeviendra faux au prochain chargement si la cause reste en amont. Contrôles de saisie, listes de valeurs fermées, champs obligatoires, validation du format au moment de la frappe : il s'agit souvent d'une modification de formulaire, pas d'un chantier technique. Dans beaucoup de cas, c'est l'intervention qui demande le moins d'effort pour l'effet le plus durable, et c'est pourtant celle qu'on saute le plus souvent parce qu'elle suppose de discuter avec les équipes qui saisissent.
6. Automatiser les contrôles dans les flux
Des tests de données automatisés exécutés à chaque chargement vérifient les règles définies plus haut : schéma modifié, volume anormal, valeurs hors plage, jointure qui ne retourne rien, champ obligatoire vide. Le flux alerte ou s'arrête avant que la donnée n'atteigne un rapport. Sans cette automatisation, la qualité repose sur la vigilance d'une personne qui regarde les chiffres avant l'envoi, ce qui tient jusqu'à ses vacances.
7. Surveiller et rendre compte dans la durée
Les métriques de l'étape trois deviennent un suivi permanent, publié au même endroit que le reste. Un tableau de bord de qualité revu à intervalle fixe rend le sujet visible, y compris pour la direction. Une revue mensuelle des alertes déclenchées et des règles les plus souvent enfreintes indique où porter l'effort suivant, et évite que la démarche s'arrête après la phase de nettoyage.
Le cadre et les responsabilités qui font tenir l'ensemble
Un cadre de qualité des données documente qui définit les règles, qui les applique, qui arbitre les désaccords et à quelle fréquence l'ensemble est revu. C'est le document le plus court du projet et celui qui détermine s'il survit au départ de la personne qui l'a lancé.
Au Québec, la Loi 25 ajoute une dimension réglementaire à ce cadre pour tout ce qui touche les renseignements personnels : consentement, durée de conservation, traçabilité des accès. Des données dupliquées dans cinq systèmes rendent ces obligations beaucoup plus difficiles à tenir, ce qui donne à la qualité un argument de conformité en plus de l'argument opérationnel. Les règles d'accès et de conservation se posent au même moment que les règles de qualité, sur les mêmes flux.
Reste la question des ressources. Une équipe interne garde le contrôle mais mobilise des compétences rares. Un outil en libre-service abaisse la barrière technique tout en laissant la configuration et la surveillance à la charge de l'entreprise. Une plateforme et un service managés prennent en charge les contrôles et leur exploitation quotidienne. C'est l'approche que privilégie BEEM, avec la plateforme et l'accompagnement dans le même mandat.
Vos équipes passent encore des heures à réconcilier des fichiers avant chaque rapport ? Voyez comment BEEM fiabilise vos données et prend en charge les contrôles au quotidien, sans mobiliser une équipe technique interne.
