Solutions  /  Intelligence artificielle

Une architecture IA en entreprise qui garde vos données au Canada

BEEM place une seule fondation de données gouvernée sous chaque outil d’IA de votre équipe. Posez vos questions en langage courant, générez des tableaux de bord à partir d’une phrase, et gardez vos données confidentielles dans votre environnement AWS dédié au Canada.

Fonctionne sur AWS au Canada (ca-central-1). Vos données n’entraînent jamais les modèles.

750+ connecteurs vers les systèmes comptables, CRM, de paie et ERP que vous utilisez déjà.

Des premiers tableaux de bord en direct sur vos vraies données en aussi peu que 2 semaines.

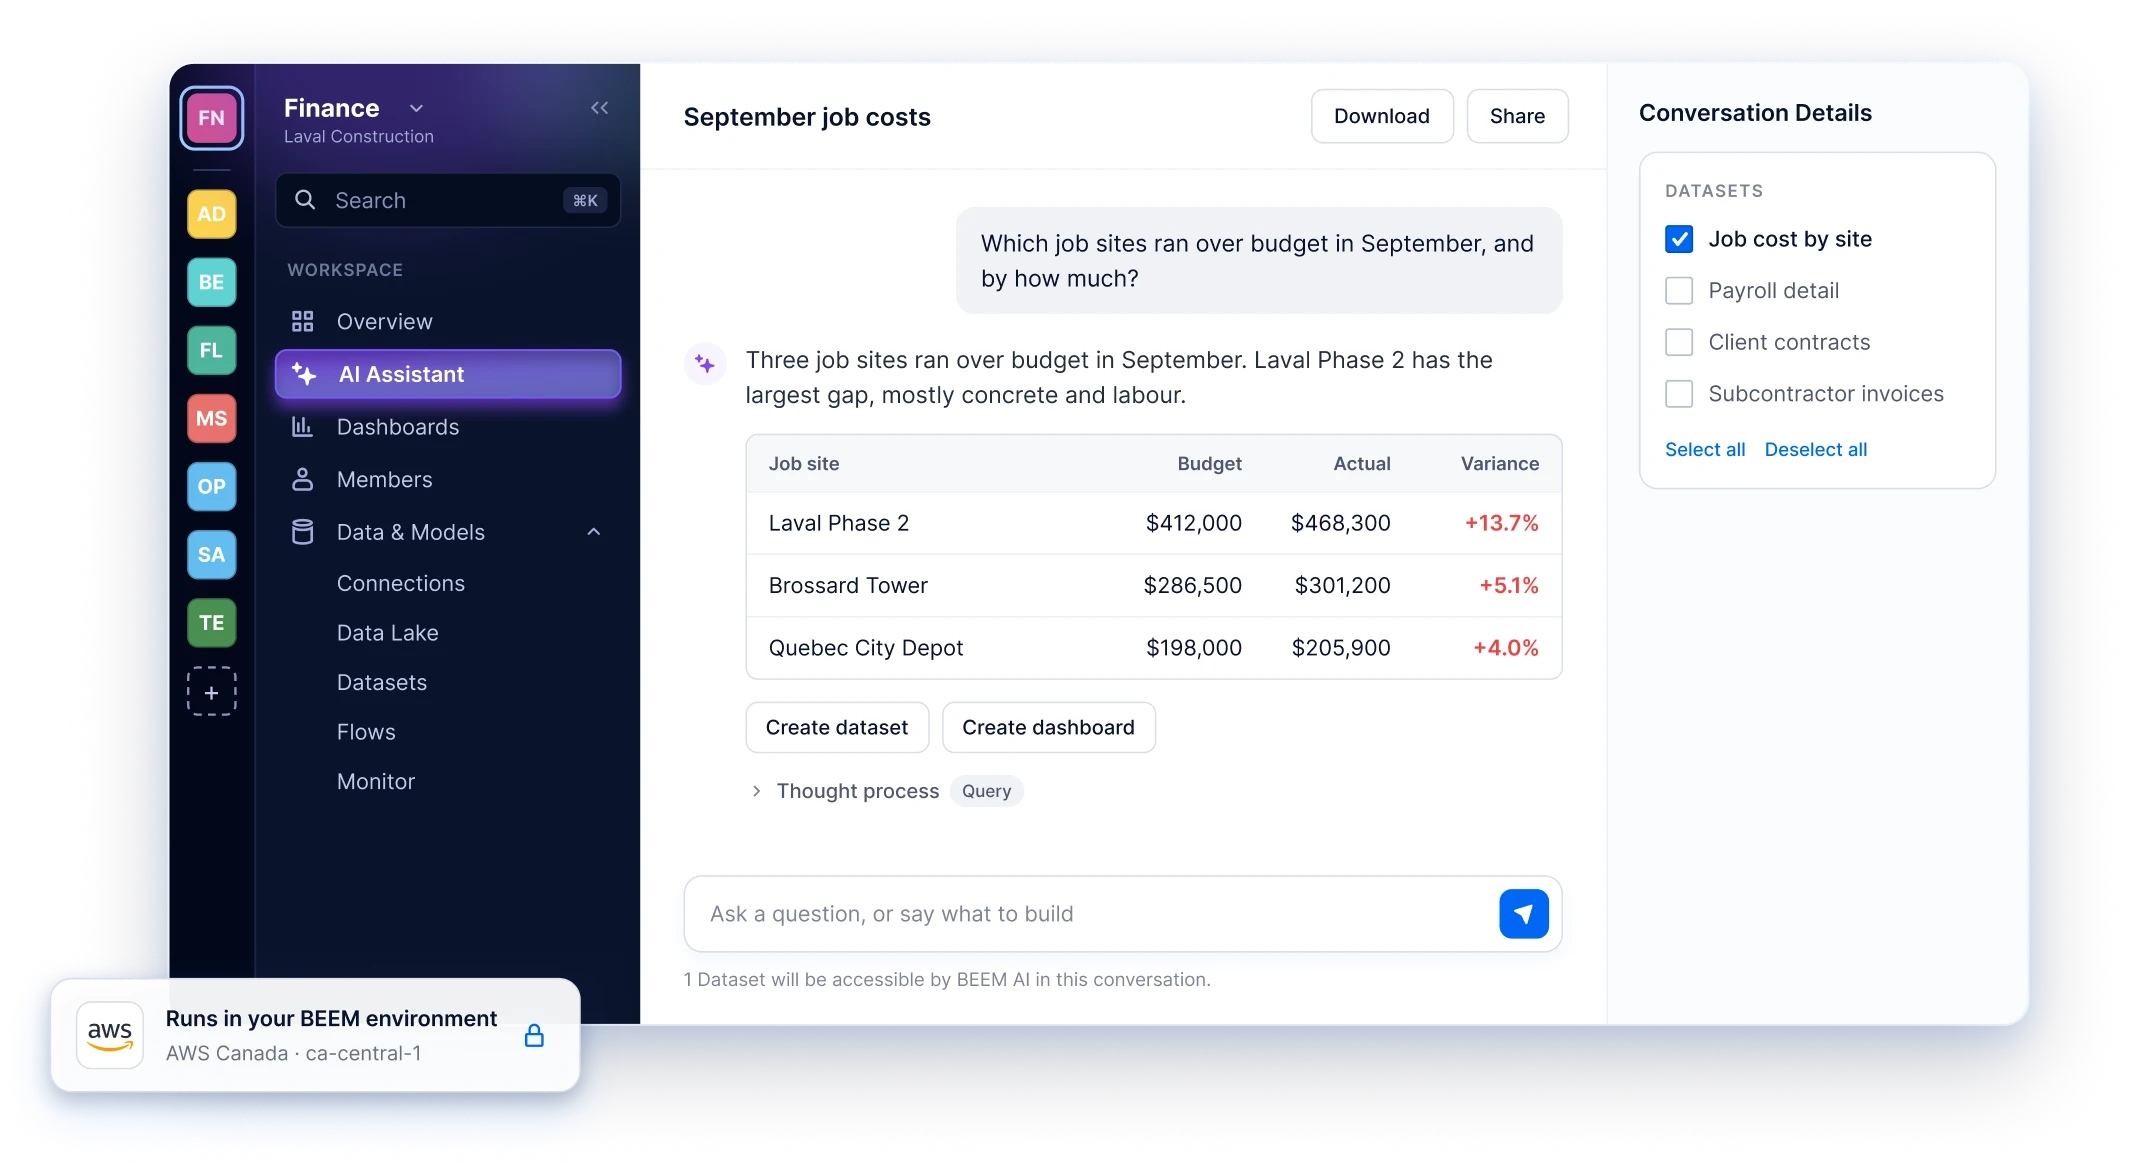
BEEM AI Assistant answering which job sites ran over budget in September, with a budget versus actual table by job site, next to a badge reading Runs in your BEEM environment, AWS Canada · ca-central-1

Des entreprises qui roulent sur BEEM

Coffrages SynergyEMD BatimoGroupe GeyserDemers BeaulneLe Groupe MauriceMG Construction
Résidences des BâtisseursGroupe PetraPopeye's Supplements

« Avec BEEM, nous avons déjà cette solution clé en main avec des spécialistes internes. Nous pouvons passer directement à l’analyse sans avoir à monter un projet qui pourrait prendre des années. »

Hughes Gagnon, VP Innovation et technologie, Coffrages Synergy

La réponse courte

Qu’est-ce que l’architecture IA en entreprise?

L’architecture IA en entreprise, c’est la façon dont une entreprise relie l’IA à ses données : quels systèmes l’IA lit, où voyagent les données, qui contrôle l’accès, et comment les réponses restent cohérentes d’un outil à l’autre.

  1. Quels systèmes l’IA lit
  2. Où voyagent les données
  3. Qui contrôle l’accès
  4. Comment les réponses restent cohérentes
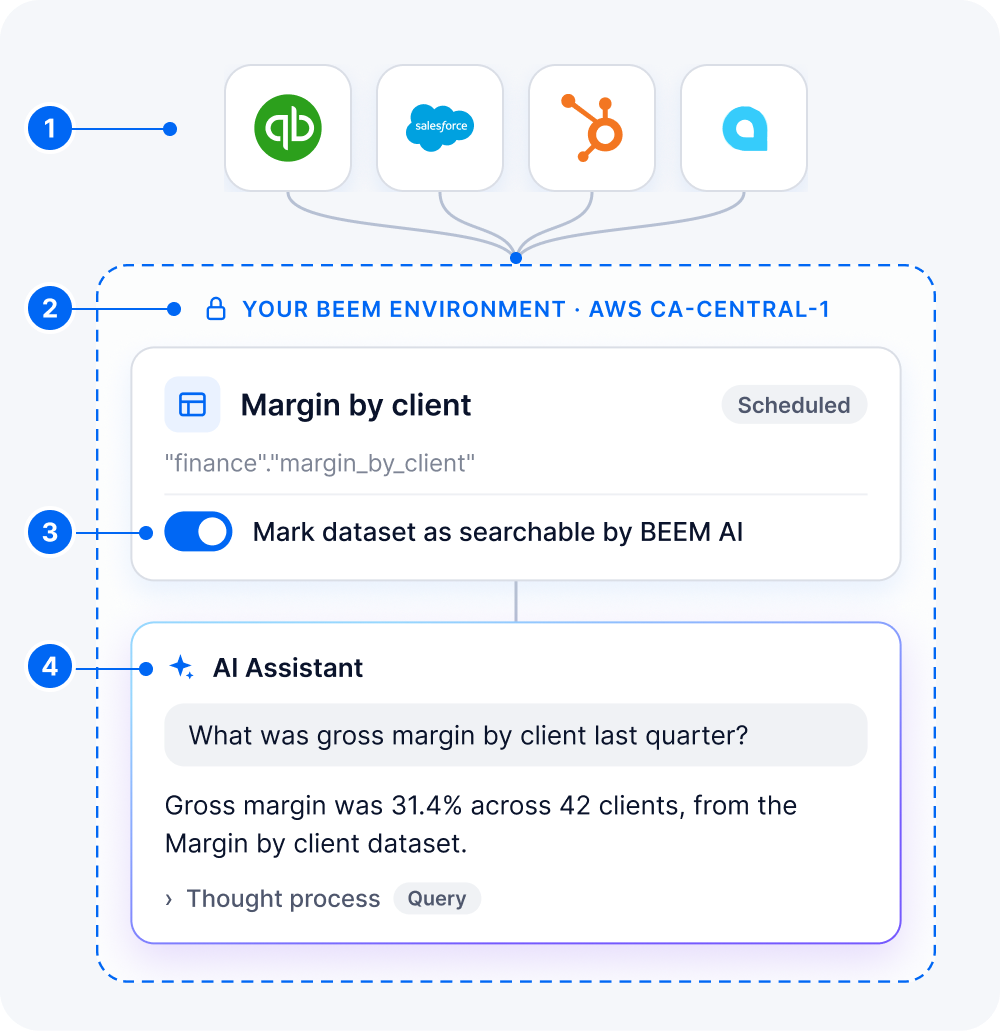
Diagram of enterprise AI architecture in BEEM: QuickBooks, Salesforce, HubSpot and Acumatica (1) feed into your BEEM environment on AWS ca-central-1 (2), where the Margin by client dataset is marked as searchable by BEEM AI (3), and the AI Assistant answers “What was gross margin by client last quarter?” from that dataset (4).

Il existe trois modèles courants : l’IA branchée séparément sur chaque système d’affaires, un assistant généraliste comme Claude ou ChatGPT relié à une plateforme de données gouvernée, ou l’IA déployée à l’intérieur de cette plateforme pour que les données ne quittent jamais votre environnement. BEEM est une plateforme de données gérée qui prend en charge les deux derniers, sur AWS au Canada, avec 750+ connecteurs vers les systèmes que vous utilisez déjà.

Pourquoi c’est important

Le problème avec l’IA non encadrée en entreprise

La plupart des entreprises n’ont pas choisi leur architecture IA. Elles en ont hérité par accident.

Le logiciel comptable a ajouté un assistant. Le CRM en a ajouté un autre. Quelqu’un aux opérations a collé un export de ventes dans une fenêtre de clavardage pour avoir un résumé avant une réunion. Pris un par un, ces gestes sont raisonnables. Ensemble, ils créent trois problèmes qui éclatent au même endroit : la réunion de direction.

Cinq outils, cinq versions de la vérité.

Chaque assistant ne voit que le système où il vit. L’IA du CRM répond à partir des ventes conclues, l’IA comptable à partir des revenus constatés, et les deux ne concordent jamais. Personne ne sait à laquelle se fier, alors la réunion retourne au chiffrier.

Les données sortent par la porte de côté.

Un copier-coller dans un outil de clavardage public envoie noms de clients, marges et paie à un fournisseur que personne n’a évalué. Il n’y a aucune trace de ce qui est sorti, et aucun moyen de le récupérer.

Des règles d’accès qui n’existent nulle part.

Chaque outil a ses propres permissions, réglées par la personne qui l’a installé. La question « qui peut interroger l’IA sur les salaires » n’a pas de réponse unique, et c’est exactement celle que posera un auditeur ou un conseil d’administration.

L’IA gouvernée, c’est l’inverse : une seule source de données propre, un seul ensemble de règles d’accès, et une trace claire de l’endroit où vont les données. C’est moins une question de modèle que d’architecture sous le modèle.

Comparez les modèles

Les 3 modèles de déploiement de l’IA, comparés

La différence entre les trois modèles se résume à deux questions : l’IA lit-elle une seule source de données gouvernée, et ces données quittent-elles votre environnement pour produire une réponse? Seule l’IA déployée dans votre environnement BEEM répond oui et non.

Critère

1. L’IA dans chaque système source

2. Claude ou ChatGPT relié à BEEM par MCP

3. L’IA déployée dans votre environnement BEEM

Ce que l’IA voit

Un système à la fois

Vos données connectées et nettoyées dans BEEM

Vos données connectées et nettoyées dans BEEM

Les chiffres concordent-ils

Non, chaque outil répond à partir de son silo

Oui, une seule source

Oui, une seule source

Qui contrôle l’accès

Chaque outil, séparément

Vos permissions BEEM

Vos permissions BEEM, plus les jeux de données que vous activez pour l’IA

Où vont les données

Vers l’IA de chaque fournisseur

Vers le fournisseur de l’assistant, pour les lignes qu’il récupère

Nulle part. Elles restent dans votre environnement AWS dédié au Canada

Journal d’audit

Éparpillé ou absent

BEEM consigne les requêtes

BEEM consigne chaque question

Verrouillage

Un par fournisseur

Faible. MCP est un standard ouvert

Faible. Vos données et vos règles restent dans BEEM, le modèle peut changer

Idéal pour

Des tâches rapides dans un seul outil

Les équipes qui travaillent déjà dans Claude, Copilot ou ChatGPT

Finance, RH, données clients, tout ce qui est confidentiel

Comment fonctionne chaque modèle

Comment fonctionne chaque modèle de déploiement de l’IA

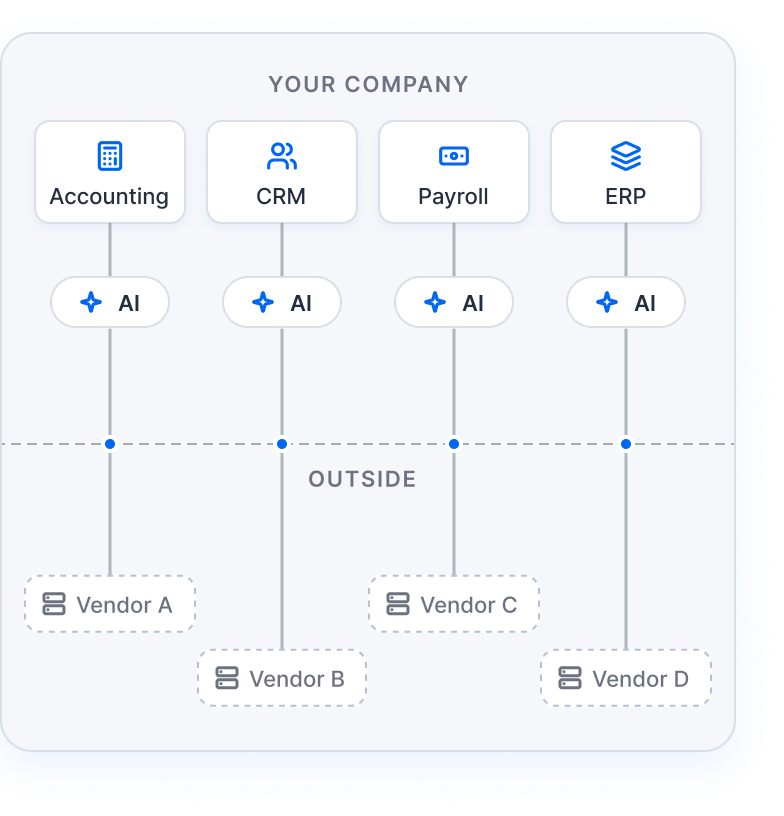
Diagram: Accounting, CRM, Payroll and ERP each have their own AI, and each AI sends data outside the company to a separate vendor (Vendor A, B, C and D).

1

L’IA branchée directement sur vos systèmes sources

C’est le modèle que la plupart des entreprises ont aujourd’hui, sans l’avoir choisi. Chaque application d’affaires livre sa propre IA, ou quelqu’un relie un assistant de clavardage à chaque système, un à la fois.

Ça fonctionne pour les tâches qui vivent dans un seul outil : rédiger un courriel dans le CRM, classer une transaction dans le logiciel comptable. Ça ne tient plus dès qu’une question touche deux systèmes, ce qui est le cas de la plupart des questions d’un dirigeant. « Quels clients sont rentables » demande la facturation, les heures et les coûts ensemble. Aucune application ne les a toutes, donc aucune IA d’application ne peut répondre.

Ce modèle multiplie aussi les endroits où vont vos données. Chaque fournisseur les traite selon ses propres conditions, et chacun est un contrat de plus à examiner.

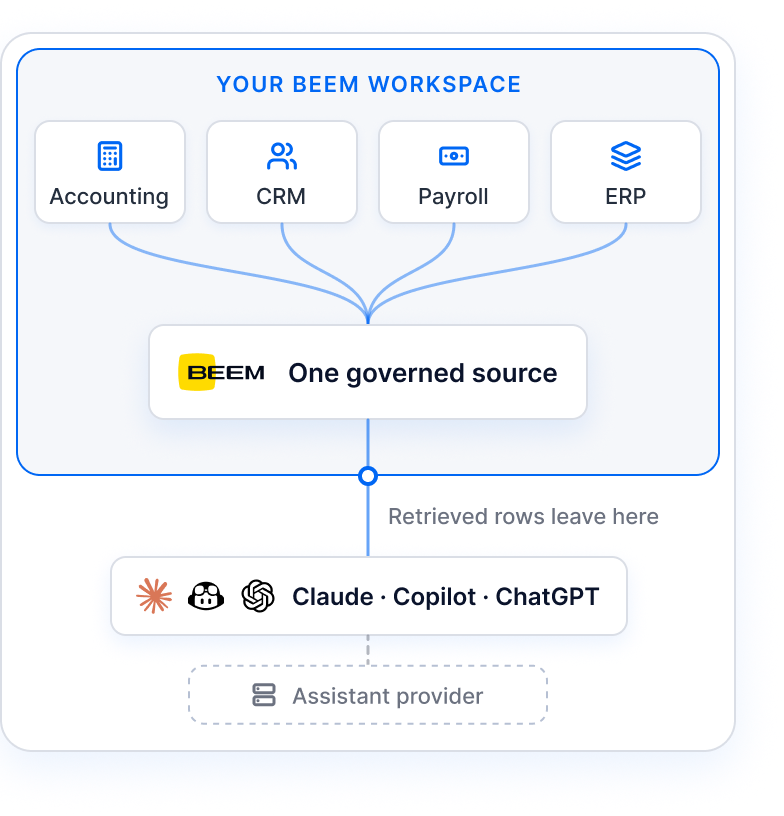
Diagram: Accounting, CRM, Payroll and ERP flow into BEEM as one governed source inside your BEEM workspace; Claude, Copilot or ChatGPT connect to it, and the retrieved rows leave the workspace to the assistant provider.

2

Claude ou ChatGPT connecté à BEEM par MCP

MCP, le Model Context Protocol, est un standard ouvert qui permet à un assistant IA de se connecter à une source de données et de l’utiliser au moyen d’outils définis. Le serveur MCP de BEEM relie Claude, GitHub Copilot, ChatGPT et d’autres assistants compatibles MCP, six ou plus en tout, à votre espace de travail BEEM avec une seule URL et votre connexion habituelle.

L’assistant arrête de deviner d’un silo à l’autre. Il travaille à partir des données connectées et nettoyées dans BEEM, au moyen de 56 outils : parcourir les jeux de données, lancer une requête, vérifier si la synchronisation de la nuit dernière a réussi, mettre en place un test de qualité des données. Les permissions suivent le compte BEEM de la personne, donc l’assistant ne voit que ce que cette personne a le droit de voir, et BEEM garde une trace des requêtes.

Une chose à savoir clairement. L’assistant lui-même fonctionne chez son fournisseur, donc les lignes qu’il récupère pour répondre à une question sont transmises à ce fournisseur, selon l’entente que vous avez avec lui. Ce modèle convient aux équipes qui vivent déjà dans un de ces assistants et qui veulent qu’il travaille à partir des bons chiffres. Pour vos données les plus confidentielles, le troisième modèle est le plus sûr.

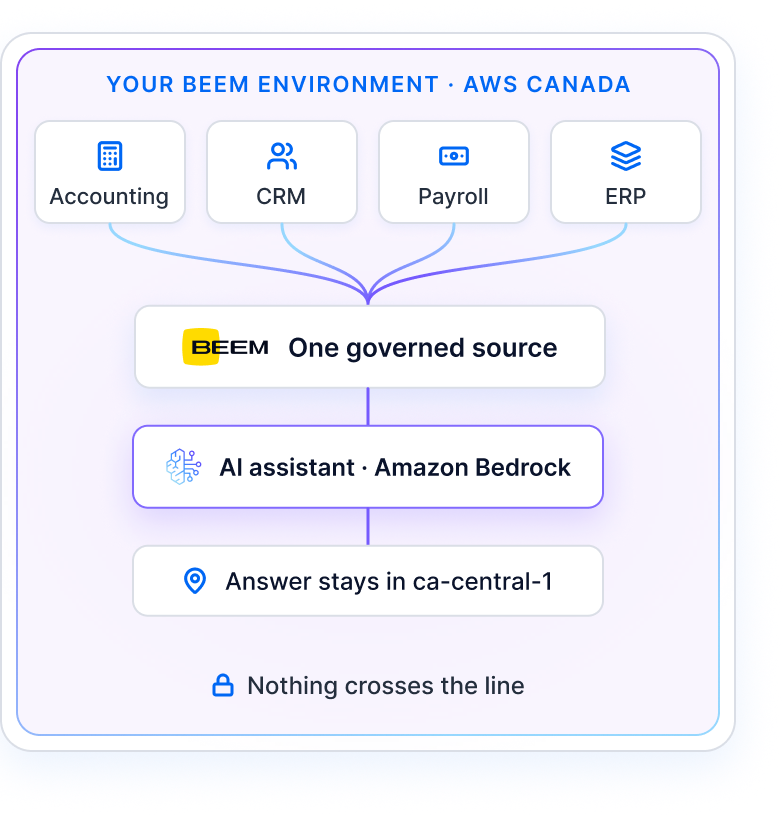
Diagram: inside your BEEM environment in AWS Canada, Accounting, CRM, Payroll and ERP flow into BEEM as one governed source, then to the AI assistant on Amazon Bedrock; the answer stays in ca-central-1 and nothing crosses the line.

3

L’IA déployée dans votre environnement BEEM

Ici, c’est l’IA qui vient aux données, et non l’inverse. L’assistant IA et les tableaux de bord IA de BEEM fonctionnent sur AWS Bedrock à l’intérieur de votre environnement BEEM dédié, dans la région canadienne d’AWS. Vos données ne quittent pas cet environnement pour produire une réponse.

L’assistant répond aux questions en langage courant en écrivant et en exécutant la requête sur vos jeux de données, et il montre le SQL si quelqu’un veut le vérifier. Les tableaux de bord IA se créent au complet à partir d’une description d’une phrase, branchés sur vos données en direct, avec la possibilité de forer jusqu’aux lignes derrière chaque total. Les deux n’accèdent qu’aux jeux de données que vous avez activés pour l’IA, les deux respectent l’isolation des espaces de travail, et chaque question est consignée dans le journal d’audit Monitor.

C’est le modèle que nous recommandons pour tout ce qui est confidentiel : états financiers, paie, dossiers clients, données d’exploitation sur les résidents ou les patients.

Comment ça fonctionne

Comment déployer l’IA sur vos données avec BEEM

Trois étapes, de systèmes éparpillés à des réponses d’IA auxquelles vous pouvez vous fier. La plupart des équipes voient leurs premiers tableaux de bord en direct en aussi peu que 2 semaines.

  1. 1

    Connectez vos systèmes

    Choisissez parmi 750+ connecteurs pour votre comptabilité, votre CRM, votre paie et votre ERP. BEEM charge et nettoie les données dans votre propre entrepôt.

  2. 2

    Choisissez ce que l’IA peut voir

    Activez les jeux de données que l’IA peut utiliser, espace de travail par espace de travail. La paie peut rester hors de portée pendant que les comptes clients sont inclus.

  3. 3

    Questionnez, bâtissez et partagez

    Posez vos questions en langage courant, générez des tableaux de bord IA à partir d’une phrase, ou connectez Claude, Copilot ou ChatGPT par MCP.

Sécurité et résidence des données

L’IA en entreprise est-elle sûre pour les données confidentielles?

Oui, quand l’IA fonctionne là où vivent les données. Dans BEEM, l’assistant IA et les tableaux de bord IA fonctionnent dans votre environnement AWS dédié au Canada, n’accèdent qu’aux jeux de données que vous activez, et consignent chaque question.

Est-ce que l’IA s’entraîne sur nos données?

Non. L’IA de BEEM fonctionne sur AWS Bedrock à l’intérieur de votre environnement dédié, et vos données ne servent pas à entraîner les modèles. L’IA lit vos données pour répondre à une question, puis la réponse reste chez vous.

Où sont nos données quand on utilise l’IA dans BEEM?

Dans un environnement AWS dédié au Canada, dans la région ca-central-1. L’IA fonctionne à l’intérieur de cet environnement, donc répondre à une question n’envoie vos données nulle part ailleurs. BEEM suit des processus SOC2, est conforme à la LPRPDE et au RGPD, et n’a connu aucune fuite de données clients.

Qui décide de ce que l’IA peut voir?

Vous, jeu de données par jeu de données. L’assistant IA n’accède qu’aux jeux de données que vous avez activés pour lui. La paie peut rester hors de portée pendant que les comptes clients sont inclus. En plus, les gens ne voient que les espaces de travail auxquels ils sont invités, les rôles sont définis par espace de travail (Organization Admin, Editor, Viewer), et les résultats peuvent être partagés sans exposer la requête qui les produit. Chaque question est consignée dans le journal d’audit Monitor.

AWS ca-central-1

Processus SOC 2

LPRPDE

RGPD

Aucun entraînement de modèle sur vos données

Journal d’audit Monitor

Aucun verrouillage fournisseur

Évitez le verrouillage fournisseur en IA : changez de modèle sans tout reconstruire

Les modèles d’IA s’améliorent tous les quelques mois. Celui que vous choisissez aujourd’hui ne sera pas le meilleur dans deux ans. Une architecture qui attache vos données et vos règles d’affaires à un seul modèle vous oblige à tout reconstruire à chaque fois.

BEEM sépare les deux couches.

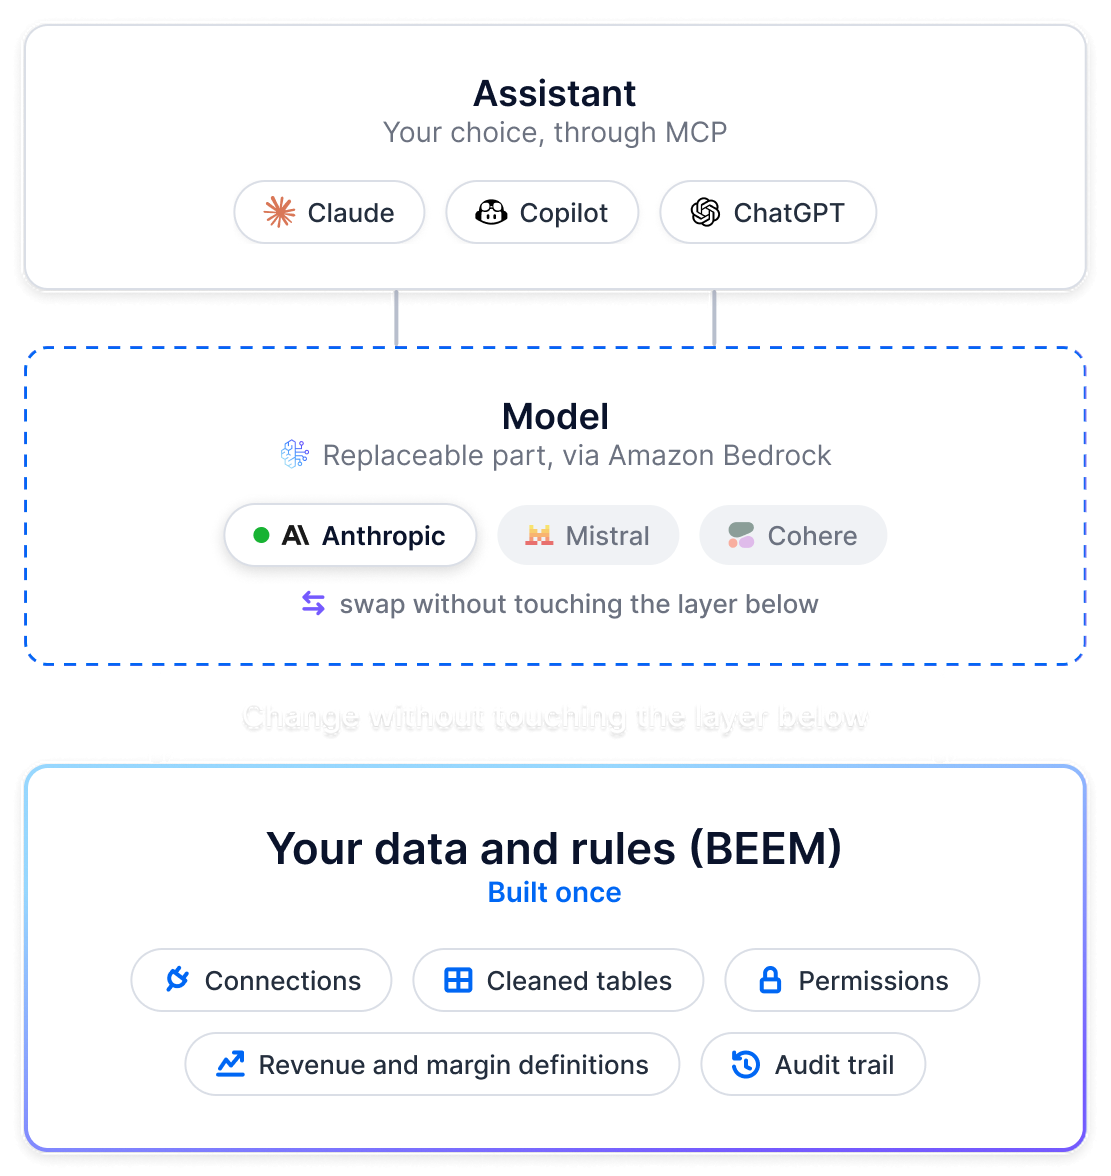
Three-layer diagram: the assistant layer (Claude, Copilot or ChatGPT through MCP) sits on a replaceable model layer via Amazon Bedrock (Anthropic, Mistral, Cohere), which sits on your data and rules in BEEM, built once: connections, cleaned tables, permissions, revenue and margin definitions, audit trail.

Vos données et vos règles vivent dans BEEM. Les connexions à vos systèmes, les tables nettoyées, les définitions du revenu et de la marge, les permissions et le journal d’audit sont tous dans la plateforme. Rien de tout ça n’est écrit dans un modèle.

Le modèle est une pièce remplaçable. L’IA de BEEM fonctionne sur AWS Bedrock, qui donne accès à plusieurs familles de modèles, dont Anthropic, Mistral et Cohere. Quand un meilleur modèle devient disponible, le modèle sous-jacent peut changer pendant que vos jeux de données, vos tableaux de bord et vos règles d’accès restent exactement les mêmes.

L’assistant est aussi votre choix. Comme MCP est un standard ouvert, l’équipe qui préfère Claude et celle qui préfère Copilot peuvent toutes deux travailler sur les mêmes données gouvernées. Changer d’assistant plus tard ne veut pas dire déménager vos données.

Vos données ne sont jamais prises au piège. Elles sont dans votre propre entrepôt dans BEEM, et les résultats peuvent être exportés en tout temps.

C’est ce qu’éviter le verrouillage fournisseur veut dire concrètement : la partie coûteuse, votre fondation de données, se bâtit une seule fois, et la partie qui change le plus vite peut changer sans y toucher.

Pourquoi BEEM

Pourquoi BEEM pour l’IA en entreprise

La plupart des plateformes IA en libre-service vous vendent un outil et vous laissent le soin de l’opérer, de le sécuriser et de le faire adopter. BEEM livre ensemble la fondation de données, la gouvernance et l’IA, pour qu’une entreprise de taille moyenne sans équipe de données puisse déployer l’IA de façon sécuritaire.

La gouvernance dès le premier jour

Un seul entrepôt pour vos données connectées, des règles d’accès par espace de travail et par jeu de données, et une IA qui fonctionne à l’intérieur de votre environnement. Rien à greffer plus tard.

Une équipe de données quand vous en voulez une

L’équipe de données de BEEM peut mettre en place les connexions, activer les bons jeux de données et suivre les résultats avec vous. Facturée séparément, en option.

Bâtie autour des chiffres de votre industrie

Le suivi des coûts par projet en construction, le rôle de loyers en immobilier, des chiffres prêts pour la conformité en finance et en comptabilité, les ventes et l’inventaire dans le commerce de détail. La même gouvernance partout.

Testimonials

Trusted by the teams who run on BEEM

Speed
2 weeks~

from kickoff to first live dashboards

Cost
40 to 60%↓

less than an in-house team or an outside consultant

Reporting
75%↓

less time spent on reporting for a finance client

Par industrie

L’IA en entreprise par industrie

L’architecture est la même partout. Les questions, elles, changent. Chaque page ci-dessous montre à quoi ressemble l’IA sur les données qu’une industrie utilise vraiment.

Finance

Où en est la trésorerie avant la fin du trimestre?

L’IA en finance →

Cabinets comptables

Quels clients sont rentables après les radiations?

Construction

Quels projets font vraiment de l’argent, chaque semaine?

Immobilier

Chaque immeuble et chaque indicateur, au même endroit

Fabrication

Quelle est la marge par gamme de produits, après les rebuts?

Commerce en ligne

Quelle est la marge après pub et retours, par canal?

Commerce de détail

Ventes, marge et stocks par magasin, avant l’appel de la semaine

Santé, volet exploitation

Où se perd la capacité entre l’horaire et la facture?

Hôtellerie et restauration

Main-d’œuvre, couverts et revenus par établissement, chaque matin

Transport

Coût au kilomètre et marge par voie

Distribution et commerce de gros

Quels produits et quels clients font la marge?

Résidences pour aînés

Occupation, services et personnel par résidence

Architecture IA en entreprise : questions fréquentes

Questions fréquentes

Qu’est-ce que l’architecture IA en entreprise?

C’est la façon dont une entreprise relie l’IA à ses données : quels systèmes l’IA lit, où voyagent les données, qui contrôle l’accès et comment les réponses restent cohérentes. Une bonne architecture place une seule fondation de données gouvernée sous chaque outil d’IA, au lieu de laisser chaque outil lire son propre silo.

Quelle est la différence entre connecter Claude ou ChatGPT à BEEM par MCP et déployer l’IA directement dans BEEM?

Avec MCP, votre assistant travaille à partir des données gouvernées dans BEEM et suit vos permissions BEEM, mais il fonctionne chez son propre fournisseur, donc les lignes qu’il récupère sont transmises à ce fournisseur. Avec l’IA déployée dans BEEM, l’IA fonctionne à l’intérieur de votre environnement et les données n’en sortent pas. Beaucoup d’entreprises utilisent les deux : MCP pour les questions courantes, l’IA de la plateforme pour les données confidentielles.

Qu’est-ce qu’un déploiement d’IA privé?

Un déploiement d’IA privé fait fonctionner le modèle à l’intérieur d’un environnement que l’entreprise contrôle, donc les instructions et les données ne sont pas envoyées à un service d’IA public. Dans BEEM, l’assistant IA et les tableaux de bord IA fonctionnent sur Amazon Bedrock à l’intérieur de votre environnement AWS dédié au Canada (ca-central-1), et vos données ne servent pas à entraîner les modèles.

Est-ce sécuritaire d’utiliser ChatGPT ou Claude avec les données de l’entreprise?

Tout dépend d’où vont les données. Relié à BEEM par MCP, l’assistant suit vos permissions BEEM et travaille à partir de données gouvernées, mais les lignes qu’il récupère sont transmises au fournisseur de l’assistant, selon l’entente que vous avez avec lui. Pour les données confidentielles, utilisez l’IA déployée dans votre environnement BEEM, d’où les données ne sortent pas.

Est-ce que l’IA dans BEEM s’entraîne sur nos données?

Non. L’IA fonctionne sur AWS Bedrock à l’intérieur de votre environnement BEEM dédié, et vos données ne servent pas à entraîner les modèles. Elle lit vos données pour répondre à une question, et la réponse reste chez vous.

Peut-on changer de modèle d’IA sans refaire notre architecture?

Oui. Vos connexions, vos données nettoyées, vos définitions d’affaires et vos permissions vivent dans BEEM, pas dans un modèle. L’IA de BEEM fonctionne sur AWS Bedrock, qui offre plusieurs familles de modèles, donc le modèle sous-jacent peut changer pendant que vos jeux de données et vos tableaux de bord restent tels quels.

Qu’est-ce que MCP, le Model Context Protocol?

MCP est un standard ouvert qui permet à un assistant IA de se connecter à une source de données au moyen d’outils définis. Le serveur MCP de BEEM offre 56 outils et fonctionne avec Claude, GitHub Copilot, ChatGPT et d’autres clients compatibles MCP, six ou plus en tout. Il s’ajoute avec une seule URL et votre connexion BEEM habituelle.

Comment éviter le verrouillage fournisseur avec l’IA?

Gardez vos données et vos règles d’affaires dans une plateforme que vous contrôlez, séparée du modèle et de l’assistant. Dans BEEM, vos données sont dans votre propre entrepôt, le modèle passe par AWS Bedrock et peut changer, MCP est un standard ouvert, et les résultats peuvent être exportés en tout temps.

A-t-on besoin d’une équipe de données ou d’un architecte IA?

Non. BEEM connecte vos systèmes avec 750+ connecteurs prêts à l’emploi et réunit l’entrepôt, la gouvernance et l’IA dans une seule plateforme. L’équipe de données de BEEM est offerte séparément si vous voulez de l’aide pour la mise en place ou pour une analyse précise.

Combien de temps avant de voir l’IA fonctionner sur nos propres données?

Des premiers tableaux de bord en direct sur vos vraies données en aussi peu que 2 semaines. L’assistant IA travaille sur les mêmes jeux de données dès qu’ils sont activés pour lui.

Combien ça coûte?

Les forfaits commencent à 899 $/mois, plus un traitement à l’usage à partir de 0,60 $/DPU et un stockage à 0,10 $/Go. Les services de l’équipe de données sont facturés séparément.

Poursuivez votre lecture sur l’IA appliquée à vos données