Votre équipe utilise déjà l'IA, souvent dans plusieurs outils à la fois, chacun voyant une tranche différente de l'entreprise. La question n'est plus de savoir s'il faut l'utiliser. C'est de savoir où vont vos données quand vous le faites, qui décide de ce que l'IA peut voir, et si les réponses concordent entre elles. L'intégration de l'IA en entreprise, c'est la façon dont une organisation relie l'IA à ses données : quels systèmes l'IA lit, où circulent les données, qui contrôle les accès, et comment les réponses restent cohérentes d'un outil à l'autre.
Il existe trois façons courantes de le faire. Ce guide les compare sur les questions qu'une direction se pose vraiment, et explique pourquoi une seule garde vos données confidentielles dans votre propre environnement.
Le problème avec l'IA non encadrée en entreprise
La plupart des entreprises n'ont jamais choisi comment intégrer l'IA. Elles se sont retrouvées avec une intégration par accident. Le logiciel comptable a ajouté un assistant, puis le CRM en a ajouté un autre, et quelqu'un aux opérations a collé un export de ventes dans un outil de clavardage public pour obtenir un résumé avant une réunion. Pris un par un, ces gestes se défendent. Ensemble, ils créent trois problèmes qui éclatent au même endroit, la réunion de direction.
Le premier, c'est que chaque assistant ne voit que le système où il vit. L'IA du CRM répond à partir des ventes conclues pendant que l'IA comptable répond à partir des revenus constatés, et les deux ne concordent jamais, alors la réunion retourne au chiffrier. Le deuxième, c'est que les données sortent par la porte de côté : un copier-coller dans un outil public envoie noms de clients, marges ou paie à un fournisseur que personne n'a évalué, sans aucune trace de ce qui est sorti. Le troisième, c'est que les règles d'accès n'existent nulle part en particulier. Chaque outil a ses propres permissions, réglées par la personne qui l'a installé, si bien qu'une question toute simple comme « qui peut interroger l'IA sur les salaires ? » n'a pas de réponse unique.
Une adoption encadrée de l'IA, c'est l'inverse : une seule source de données propre, un seul ensemble de règles d'accès, et une trace claire de l'endroit où vont les données. Ça dépend beaucoup moins du modèle choisi que de l'architecture qu'on installe en dessous.
Les trois façons d'intégrer l'IA en entreprise
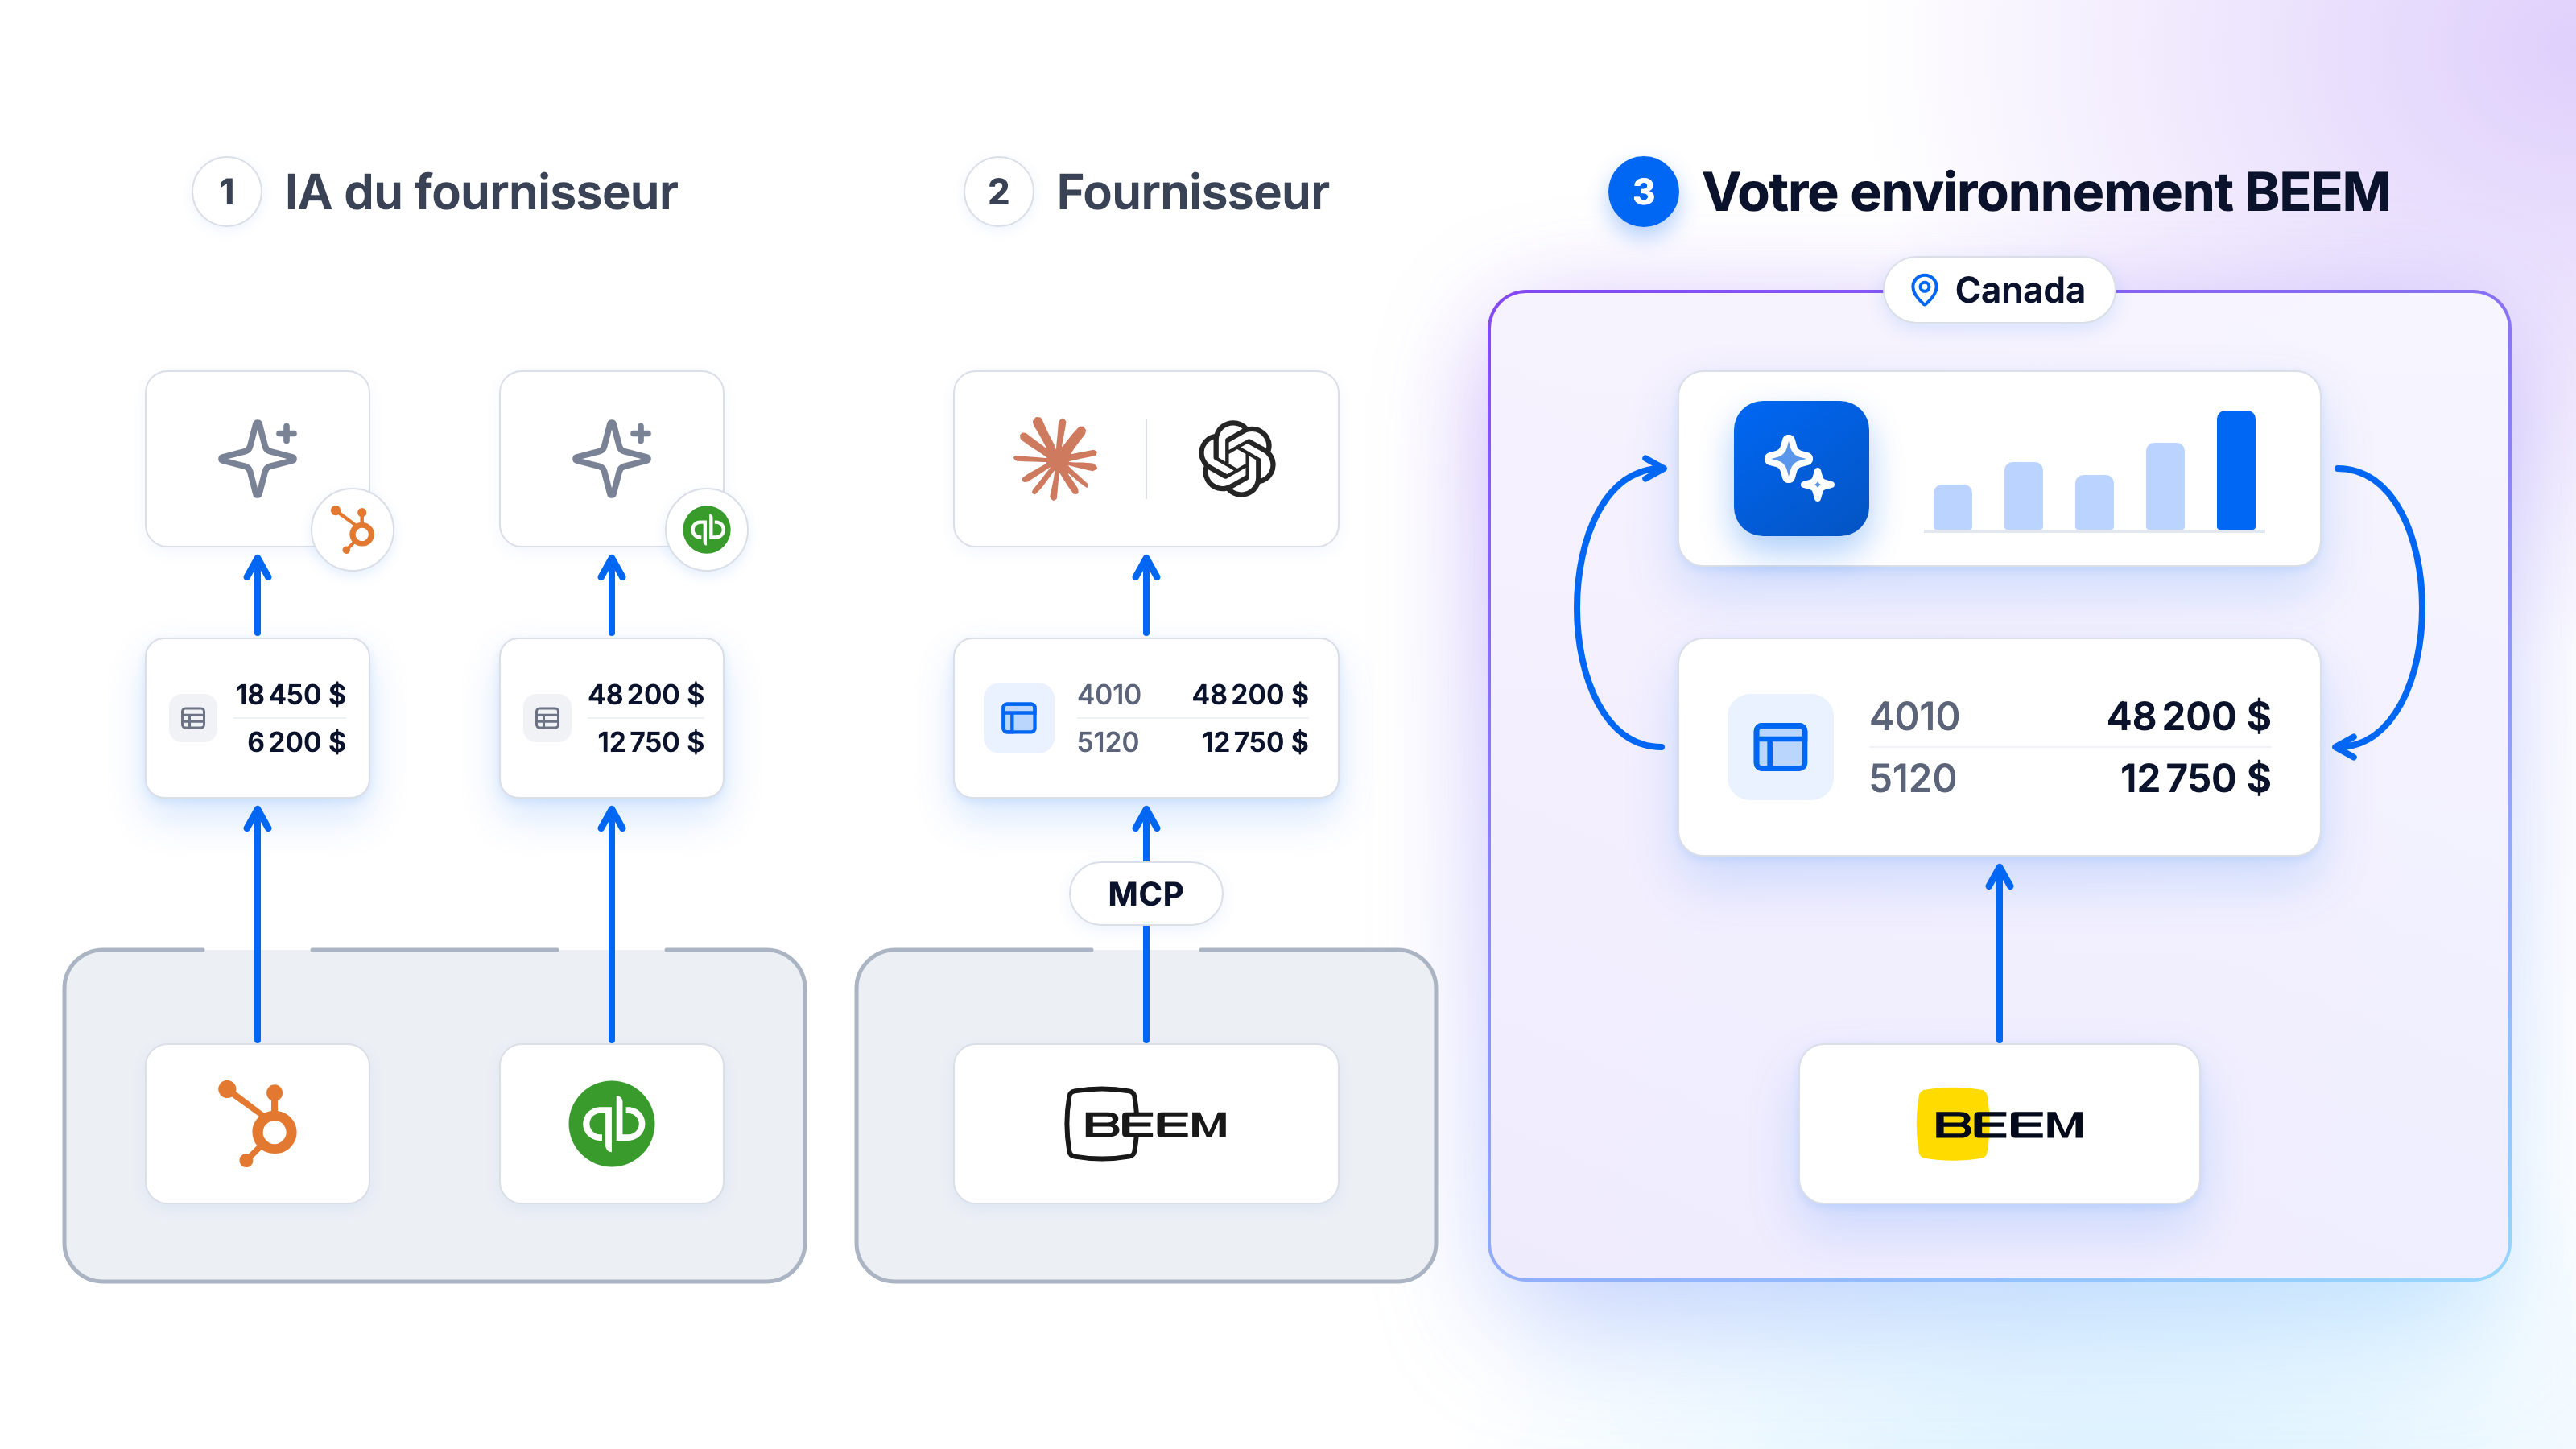
L'IA branchée sur vos systèmes sources directement
C'est le modèle que la plupart des entreprises ont aujourd'hui sans l'avoir choisi. Chaque application d'affaires livre sa propre IA, ou quelqu'un relie un assistant de clavardage à chaque système, un à la fois. Ça fonctionne bien pour les tâches qui restent dans un seul outil, comme rédiger un courriel dans le CRM ou classer une transaction dans le logiciel comptable.
Ça ne tient plus dès qu'une question touche deux systèmes, ce qui décrit la plupart des questions d'un dirigeant. Savoir quels clients sont rentables demande la facturation, les heures et les coûts ensemble, et aucune application ne détient les trois. Quant à vos données, elles partent vers l'IA de chaque fournisseur, chacun selon ses propres conditions, et chacun représente un contrat de plus à examiner.
Verdict : pratique pour des tâches rapides dans un seul outil, peu fiable pour des décisions qui touchent toute l'entreprise.
Claude ou ChatGPT connecté à BEEM par MCP
MCP, le Model Context Protocol, est un standard ouvert qui permet à un assistant IA de se connecter à une source de données au moyen d'un ensemble d'outils définis. Le serveur MCP de BEEM relie Claude, GitHub Copilot, ChatGPT et d'autres assistants compatibles MCP à votre espace de travail BEEM avec une seule URL et votre connexion habituelle.
L'assistant arrête de deviner d'un silo à l'autre et travaille à partir des données connectées et nettoyées dans BEEM, au moyen de 56 outils. Il peut parcourir les jeux de données, lancer une requête, vérifier si la synchronisation de la nuit a réussi ou mettre en place un test de qualité des données. Les permissions suivent le compte BEEM de chaque personne, donc l'assistant ne voit que ce que cette personne a déjà le droit de voir.
Un point mérite d'être dit clairement. L'assistant lui-même fonctionne chez son fournisseur, donc les lignes qu'il récupère pour répondre sont transmises à ce fournisseur, selon l'entente que vous avez avec lui.
Verdict : un très bon choix pour les équipes qui travaillent déjà dans un de ces assistants et qui veulent qu'il utilise les bons chiffres. Pour vos données les plus confidentielles, le troisième modèle est plus sûr.
L'IA déployée dans votre environnement BEEM
Ici, c'est l'IA qui vient aux données, plutôt que les données qui partent vers l'IA. L'assistant IA de BEEM, AI Insights, et les AI Dashboards fonctionnent sur AWS Bedrock à l'intérieur de votre environnement BEEM dédié, dans la région canadienne d'AWS. Vos données ne quittent pas cet environnement pour produire une réponse.
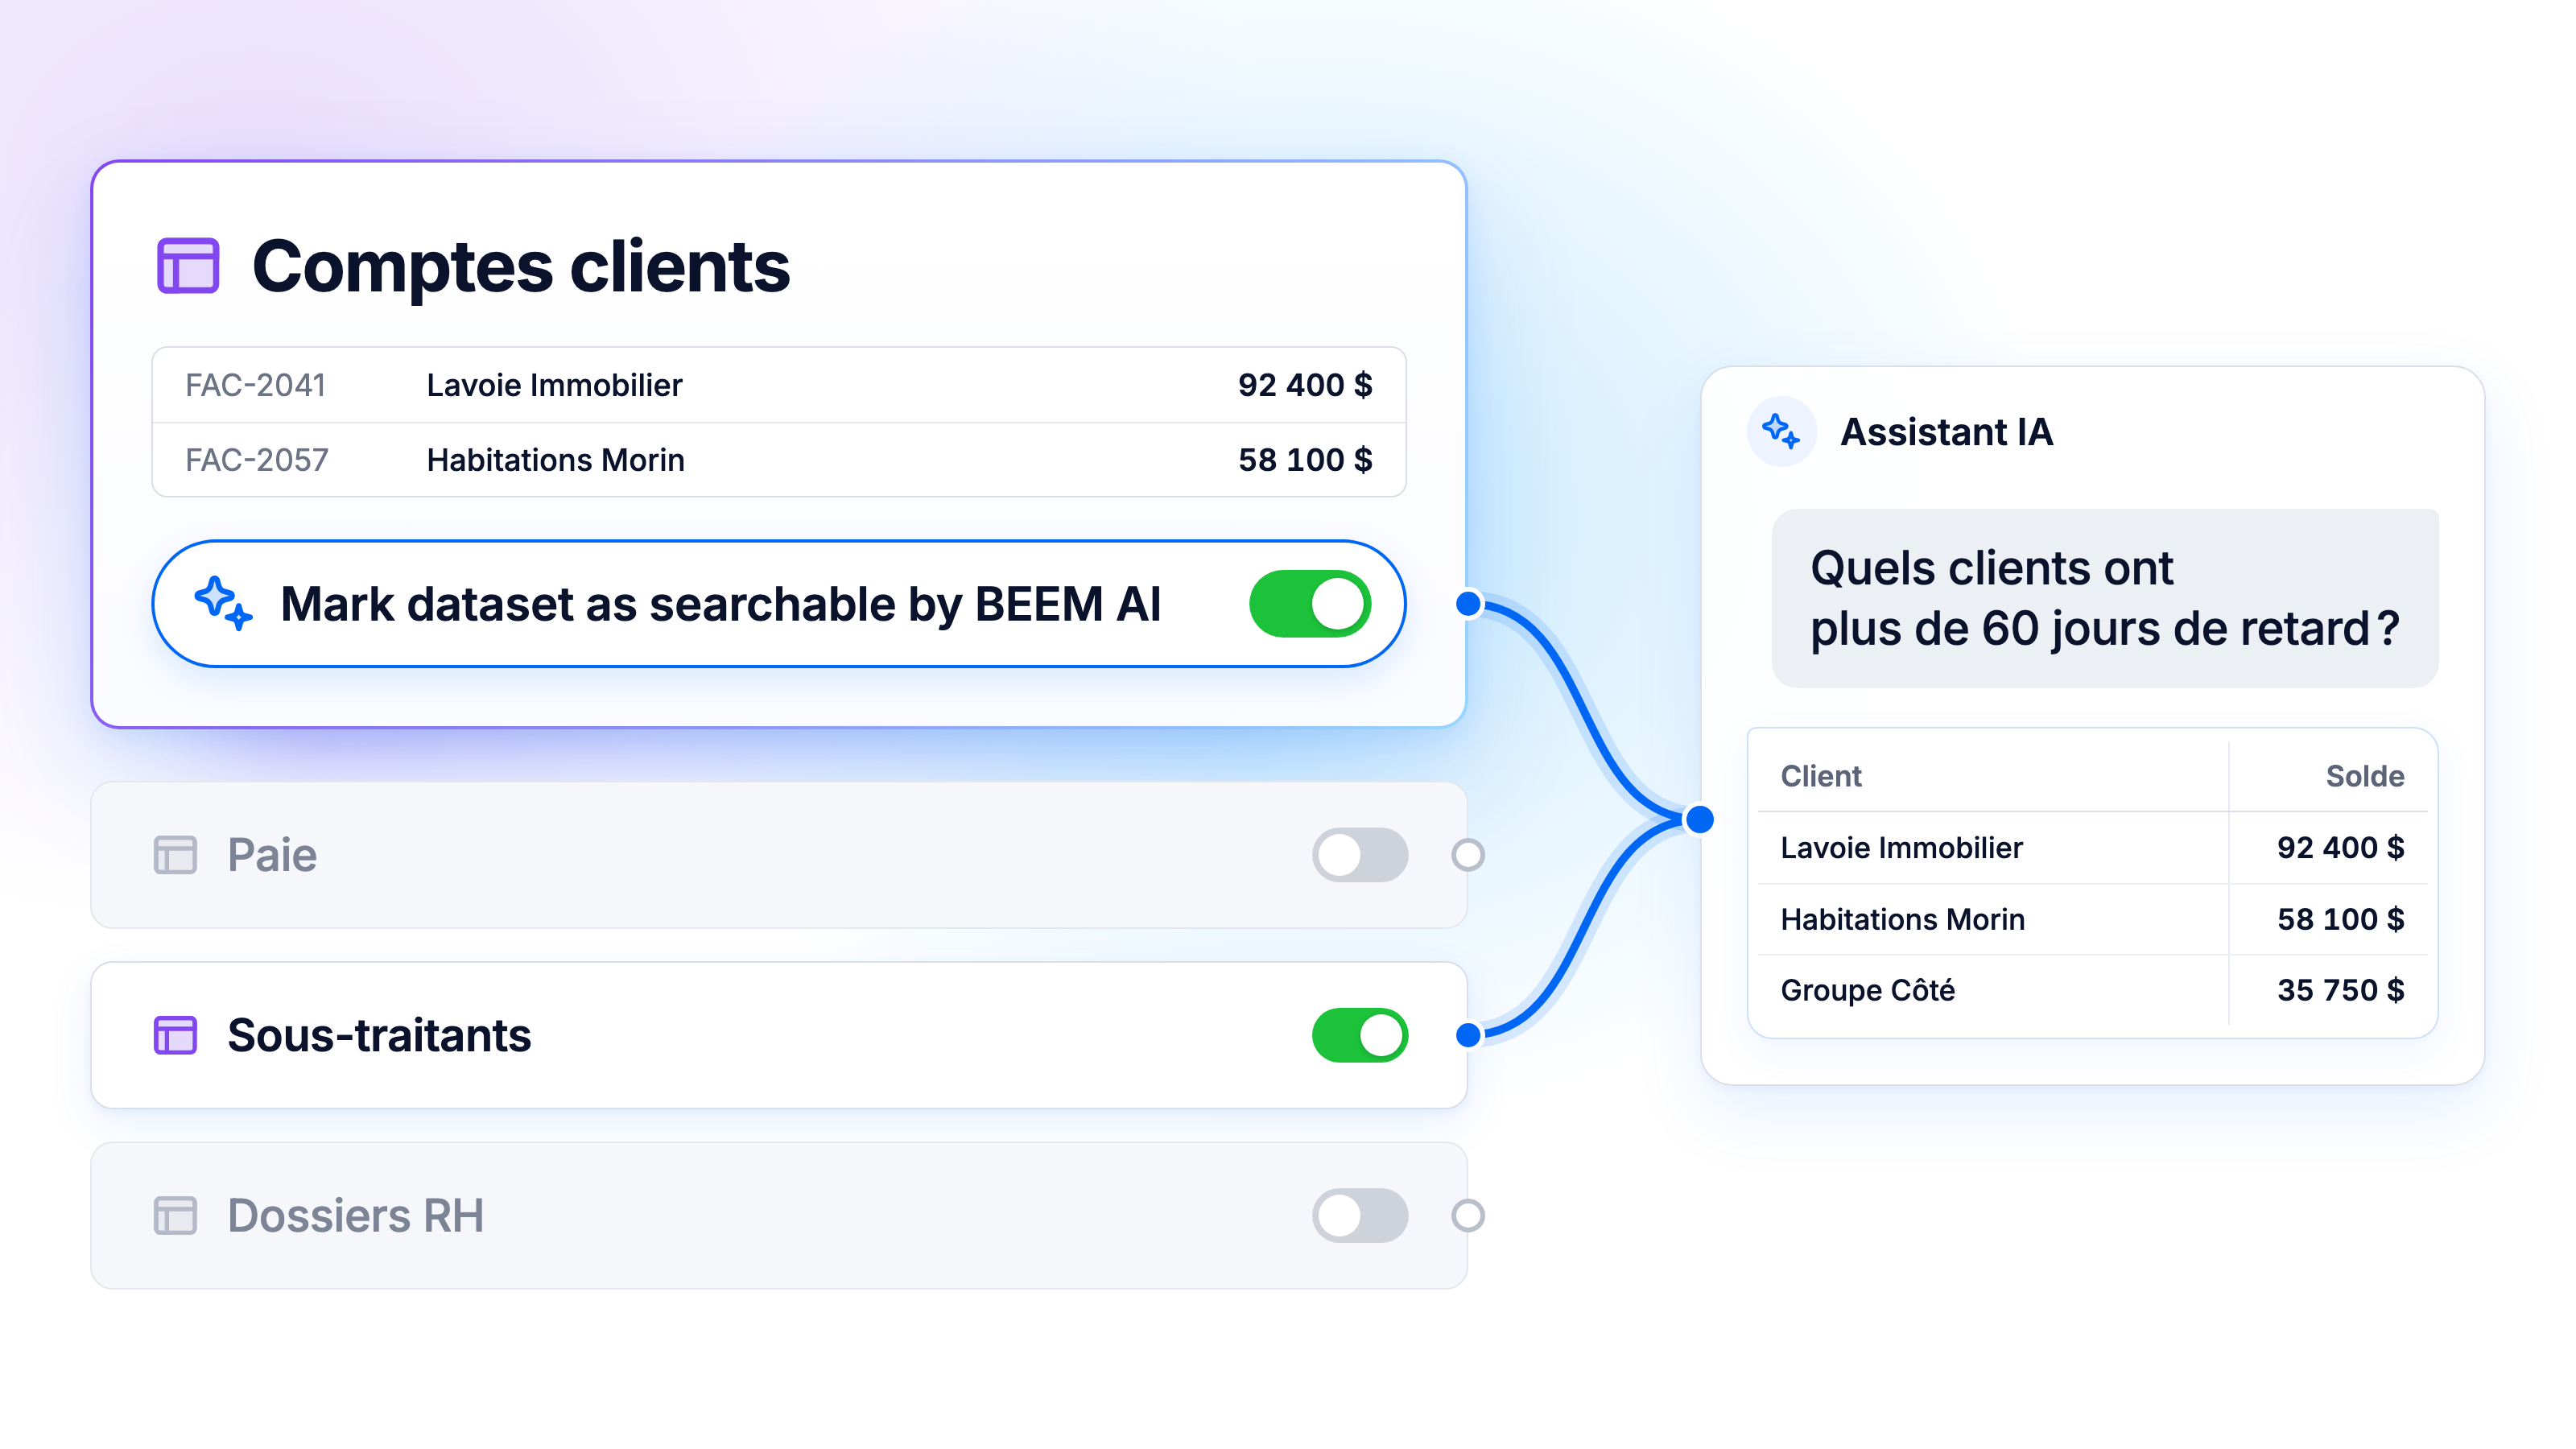
L'assistant répond aux questions posées en langage courant en écrivant et en exécutant la requête sur vos jeux de données, et il montre le SQL à quiconque veut vérifier son travail. Les AI Dashboards construisent un tableau de bord complet à partir d'une description d'une phrase, branché sur vos données en direct. Les deux n'accèdent qu'aux jeux de données que vous avez activés pour l'IA, les deux respectent l'isolation des espaces de travail, et chaque question est consignée dans le journal d'audit Monitor.
Verdict : le modèle à privilégier pour tout ce qui est confidentiel, comme les états financiers, la paie, les dossiers clients ou les données RH. Bien des entreprises l'utilisent en parallèle avec MCP, en gardant l'assistant de leur choix pour les questions courantes et l'IA intégrée à la plateforme pour les données sensibles.
Changez de modèle IA sans refaire votre intégration
Les modèles d'IA s'améliorent tous les quelques mois, et celui que vous choisissez aujourd'hui ne sera probablement pas le meilleur dans deux ans. Une intégration IA qui attache vos données et vos règles d'affaires à un seul modèle vous oblige à recommencer chaque fois que mieux apparaît. C'est à ça que ressemble le verrouillage fournisseur en IA, et il coûte cher justement parce que le travail sur les données est la partie lente.
BEEM garde les deux couches séparées. Vos connexions, vos tables nettoyées, vos définitions du revenu et de la marge, vos permissions et votre journal d'audit vivent tous dans la plateforme, et rien de tout ça n'est écrit dans un modèle. Le modèle, lui, est une pièce remplaçable. L'IA de BEEM fonctionne sur AWS Bedrock, qui offre plusieurs familles de modèles, dont Claude d'Anthropic, Mistral et Cohere, et ajoute les nouveaux modèles à mesure qu'ils sortent. Quand un meilleur modèle devient disponible, le modèle sous-jacent peut changer pendant que vos jeux de données, vos tableaux de bord et vos règles d'accès restent exactement en place.
L'assistant est aussi votre choix. Comme MCP est un standard ouvert, l'équipe qui préfère Claude et celle qui préfère Copilot peuvent toutes deux travailler sur les mêmes données gouvernées, et changer d'assistant plus tard ne demande de rien déménager. Votre fondation de données se bâtit une seule fois, et la partie qui change le plus vite peut changer sans y toucher.

Vos données dans l'infrastructure IA de BEEM : ce que ça change
La plupart des hésitations face à l'IA se résument à trois questions. Voici comment chacune se règle quand l'IA fonctionne dans l'infrastructure IA de BEEM plutôt que chez un fournisseur externe.
Vos données servent-elles à entraîner l'IA ?
Non. L'IA de BEEM fonctionne sur AWS Bedrock à l'intérieur de votre environnement dédié, et Bedrock n'utilise ni vos requêtes ni vos données pour entraîner les modèles. L'IA lit vos données pour répondre à une question, et la réponse reste chez vous.
Où vivent vos données, concrètement ?
Dans un environnement AWS dédié au Canada, dans la région ca-central-1. L'IA fonctionne dans ce même environnement, donc répondre à une question n'envoie vos données nulle part ailleurs. BEEM suit des processus SOC2, est conforme à la LPRPDE et au RGPD, et n'a connu aucune fuite de données clients.
Qui contrôle ce que l'IA peut voir ?
Vous, jeu de données par jeu de données. L'assistant IA n'accède qu'aux jeux de données que vous avez explicitement activés pour lui, donc les comptes clients peuvent être inclus pendant que la paie reste hors de portée. En plus, les gens ne voient que les espaces de travail auxquels ils sont invités, les rôles sont définis par espace de travail (Organization Admin, Editor, Viewer), et chaque question est consignée dans Monitor.
Pourquoi BEEM plutôt qu'une autre plateforme IA
La plupart des plateformes IA en libre-service vous vendent un outil : à vous de l'opérer, de le sécuriser et de former votre équipe pour l'utiliser correctement. BEEM prend une approche différente. La gouvernance est intégrée à la plateforme dès le premier jour, avec un seul entrepôt pour vos données connectées, des règles d'accès définies par espace de travail et par jeu de données, et une IA qui fonctionne dans votre environnement, si bien que la sécurité de vos données n'est pas une case à cocher que vous devez configurer vous-même. Quand vous voulez un coup de main, l'équipe derrière BEEM est disponible séparément pour mettre en place les connexions, activer chaque jeu de données et assurer le suivi, pendant que vous gardez le contrôle sur ce que l'IA peut voir. Vous n'avez pas besoin de devenir un expert en intégration IA pour bénéficier d'un déploiement sécuritaire. Pour une PME qui n'a pas les ressources pour bâtir une équipe data interne, c'est souvent ce qui fait la différence entre un projet IA qui reste un essai isolé et un projet qui livre des décisions fiables, année après année.
Cette architecture n'est pas une couche générique plaquée sur n'importe quel secteur. Elle s'adapte aux réalités de votre industrie, que ce soit le suivi de projets et la gestion de la sous-traitance en construction, la consolidation de portefeuilles et le reporting locatif en immobilier et hôtellerie, la conformité et la fiabilité des chiffres en finance et comptabilité, ou l'unification des données de vente et d'inventaire en commerce en ligne et vente au détail. Dans chacun de ces cas, le même principe s'applique : vos données restent dans votre environnement, vos règles d'affaires sont centralisées, et l'IA ne voit que ce que vous avez explicitement activé. Nos solutions IA rendent vos données prêtes pour ce type de projet, peu importe le point de départ. L'objectif reste le même quelle que soit l'industrie : vous donner une vue fiable de votre entreprise sans avoir à embaucher une équipe technique pour l'obtenir.
Vous voulez voir l'IA travailler sur vos propres chiffres sans en perdre le contrôle ? Demandez une démo BEEM pour voir l'assistant IA et les AI Dashboards sur vos vraies données, dans un environnement qui reste le vôtre.